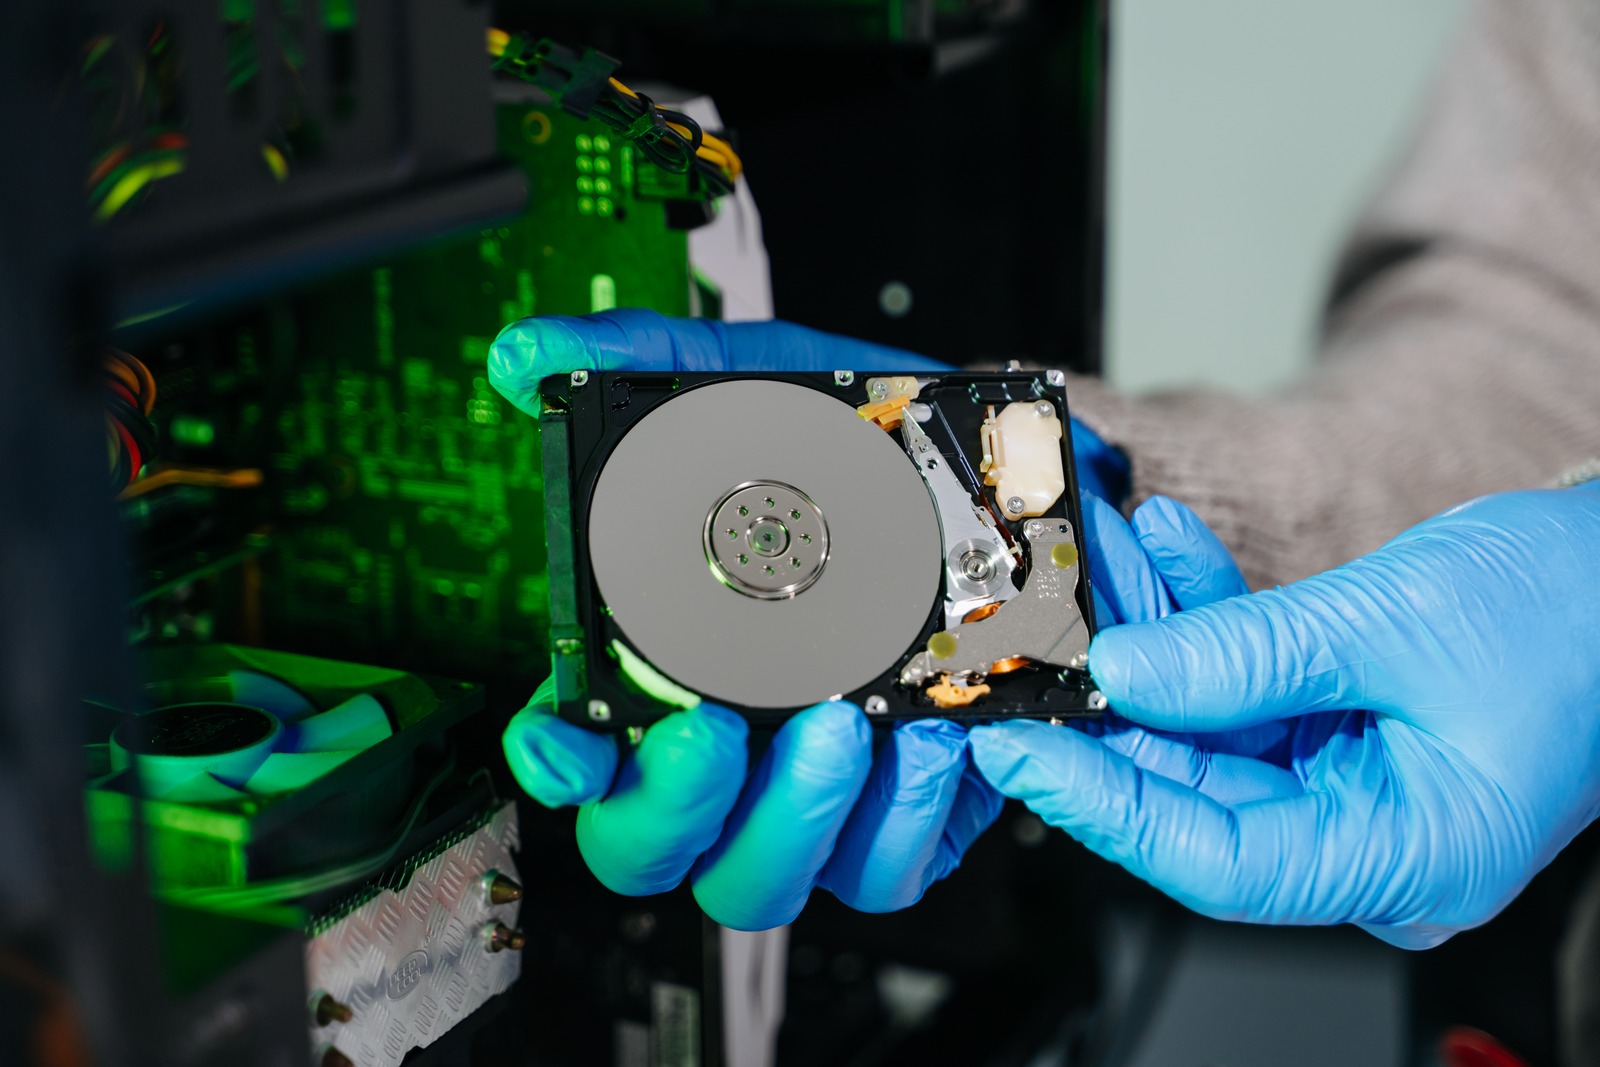
Nelle riunioni tecniche l’obiezione arriva quasi sempre nella stessa forma: «i backup li facciamo già». La frase chiude il discorso e sposta l’attenzione altrove. Poi arrivano tre domande: da quanto tempo nessuno controlla l’esito dei processi notturni, dove si trova la copia più recente, quando è stato eseguito l’ultimo ripristino documentato. Il discorso si riapre. Tra backup e disaster recovery corre la stessa distanza che separa l’avere i dati dall’avere di nuovo un’azienda che lavora.
In sala server la differenza è nota. In consiglio di amministrazione arriva sfumata. Backup e disaster recovery compaiono a bilancio sotto la stessa voce e vengono letti come una spesa già coperta.
Due progetti distinti, non due nomi per la stessa voce
Copiare il dato e rimettere in funzione l’azienda richiedono impianti differenti. Il backup produce copie, il disaster recovery garantisce la ripartenza. Due attività che condividono la tecnologia, rispondono a domande diverse e per questo si dimensionano in modo diverso.
Una copia notturna su un apparato in sede consente di recuperare un file cancellato per errore o un documento sovrascritto. Non risolve il guasto del server. In quel caso occorre acquistare o riparare il componente prima di poter ripristinare qualcosa, e il tempo di approvvigionamento diventa parte del fermo. La formula che sentiamo più spesso è «una sorta di disaster recovery». Descrive un archivio su dispositivo di rete più una replica in cloud che consentirebbe una ripartenza a caldo. Il condizionale, in quella frase, è il punto interessante: indica che nessuno ha mai provato.
Il disaster recovery vero implica risorse duplicate. Serve un’infrastruttura che replichi soltanto l’ambiente di produzione, con server applicativi e server di database speculari, pronti all’uso. Va considerato anche il tempo di spostamento dei riferimenti di rete verso il sito secondario. In un progetto per un applicativo del settore finanziario il requisito era essere operativi sul sito alternativo entro mezz’ora, spostamento dei nomi di dominio compreso. La distanza minima richiesta tra i due siti era di centocinquanta chilometri.
Tra i due estremi esiste una via intermedia, in molte realtà la risposta proporzionata. La conversione automatica dell’ultima immagine di copia in una macchina virtuale pronta all’avvio, con lavorazione incrementale dalla seconda esecuzione. La macchina così ottenuta riparte sull’ambiente di virtualizzazione già presente in azienda oppure, se anche quello è indisponibile, sull’infrastruttura cloud del fornitore della copia. Non serve un secondo sito dedicato né una connettività permanente, e la risposta alla domanda «quanto restiamo fermi» passa da giorni a ore.
Backup e disaster recovery: RTO e RPO si stabiliscono per singolo servizio
Le due sigle circolano da anni e tornano in ogni presentazione, quasi mai tradotte in numeri. La formulazione operativa è semplice: per quanto tempo l’attività può restare ferma, e quale perdita di dati, espressa in ore di lavoro, è accettabile.
Il metodo per tradurre backup e disaster recovery in numeri è un’analisi di impatto. Si individuano i servizi che tengono in esercizio l’azienda, si stabilisce per ciascuno il termine massimo entro cui deve tornare disponibile, e su quel termine si costruisce l’architettura. Il passaggio decisivo è il secondo, perché i valori non sono uguali per tutti i sistemi della stessa organizzazione.
Lo ha spiegato con chiarezza il direttore di una struttura sanitaria multisede. L’amministrazione può restare ferma qualche ora, l’operatività clinica pochissimi minuti, perché i pazienti non possono attendere una prestazione. Nella stessa azienda, quindi, convivono due architetture di ripristino diverse e due livelli di investimento diversi. Chi applica un unico valore a tutto finisce per sovradimensionare ciò che non serve e lasciare scoperto ciò che conta.
Quando l’analisi manca, la risposta è quasi sempre la stessa. «Non c’è un’analisi, qui proprio non c’è niente», e a seguire: «non l’abbiamo mai affrontato e non abbiamo mai pensato che potesse capitarci». Sono le due frasi che precedono, nella nostra esperienza, i progetti più urgenti.
Il caso di una settimana di fermo per un disco guasto
Una software house sotto i venti addetti sviluppa e ospita gestionali per clienti finali in ambito sanitario e cooperativo, su due server fisici presso un fornitore italiano. Il database veniva copiato regolarmente, in modo completo e parziale. La copia veniva scritta sulla stessa macchina che erogava il servizio.
Il rischio era noto internamente. «Servirebbe un backup su una macchina esterna, attualmente se si interrompe qualcosa siamo fermi»: la criticità era stata riconosciuta, non finanziata.
Poi si è guastato un disco del gruppo ridondato. Tutto il carico è passato sull’unità rimasta, il processore è andato a fondo scala e il sistema ha iniziato a interrompersi in continuazione. La scelta obbligata è stata acquistare un’altra macchina e spostare tutto, con un intervento che superava le competenze della persona interna.
La fornitura verso i clienti è rimasta interrotta circa una settimana: il tempo di comprare l’hardware, migrare i sistemi e ricaricare la copia. In quei giorni i clienti finali, strutture sanitarie e cooperative, hanno lavorato senza il proprio gestionale.
Quello che si racconta meno viene dopo. Quando il fornitore ha sostituito la macchina originale, l’azienda si è ritrovata con un server in più. Avrebbe dovuto diventare il nodo della continuità operativa o il deposito delle copie esterne. È rimasto vuoto e inutilizzato per un anno. L’obiettivo dichiarato dopo l’esperienza era chiaro, «se al posto di una settimana il fermo fosse di un’ora sarebbe una gran bella cosa». Ma nessuno aveva trasformato quell’obiettivo in un progetto con responsabilità e scadenze.
Insight. L’evento che innesca il danno è quasi sempre banale e prevedibile. La durata del fermo dipende in larga parte da quante decisioni restano da prendere nel momento in cui il guasto si presenta. Acquisti da autorizzare, competenze da reperire, priorità da stabilire senza una procedura scritta.
Perché una casella in cloud ha comunque bisogno di una copia separata
Lo stesso ragionamento sulle soglie di fermo vale per la posta, che nella gerarchia dei servizi critici sta quasi sempre al primo posto insieme al gestionale. L’obiezione «è in cloud, quindi è al sicuro» resiste a qualunque spiegazione tecnica, e ha una sua logica: il fornitore garantisce che il servizio funzioni. Non garantisce il recupero dei contenuti. Tre casi tipici: un messaggio eliminato oltre la finestra di conservazione nativa, un account compromesso che svuota le cartelle, una persona che lascia l’azienda e cancella i propri archivi. In nessuno di questi esiste un obbligo di restituzione.
Le finestre native si collocano tipicamente tra i trenta e i novanta giorni, e coprono la cancellazione accidentale scoperta subito. Non coprono l’esigenza di recuperare un documento a dodici mesi di distanza, né l’obbligo di conservazione che molte aziende hanno per contratto o per norma. Nel servizio gestito che eroghiamo la copia del tenant è giornaliera, con conservazione minima di sei mesi su sistemi propri in datacenter italiani. Gli esiti sono verificati periodicamente e il ripristino è granulare fino al singolo messaggio o al singolo file.
Vale la pena tenere separati due strumenti che molti confondono. La copia esiste per rimettere in funzione un sistema. L’archiviazione risponde a una richiesta di prova che arriva mesi dopo. Conserva una versione immutabile, indicizzata e ricercabile, non modificabile nemmeno da chi amministra il sistema, e ha valore probatorio. Servono entrambi, per finalità diverse. Vale anche per le copie la logica di presidio continuo descritta parlando di sicurezza gestita tra EDR, XDR, MDR e SOC. Senza qualcuno che ne controlli l’esito, un servizio attivo non è un servizio presidiato.
Backup e disaster recovery: come si prova che un ripristino funziona
La differenza pratica tra backup e disaster recovery si misura qui. Un processo di copia che termina con esito positivo dice soltanto che il sistema ha scritto i dati. Non dice che siano leggibili, né che la macchina riparta. Le due verifiche si eseguono in modo diverso e sono complementari.
La prima è la convalida per confronto: il sistema rilegge integralmente il punto di ripristino appena creato e lo verifica rispetto a quanto è stato scritto. Anticipa l’operazione che il sistema eseguirebbe durante un ripristino reale. Richiede tempo e banda, quindi nella maggior parte dei casi si pianifica separatamente dal processo di copia, anche affidandola a un altro sistema che abbia accesso all’archivio. In una realtà con un server e una decina di postazioni, il fine settimana è la finestra naturale.
La seconda è la verifica funzionale: il sistema avvia la macchina protetta in un ambiente virtuale isolato e controlla che raggiunga la propria schermata operativa. L’analisi dell’immagine è automatica e l’esito entra nella reportistica come evidenza. È la risposta alla situazione che più spaventa chi ha già vissuto un incidente, cioè l’archivio presente ma non avviabile.
C’è un terzo scenario che raramente entra nelle valutazioni. Un malware può restare silente nell’infrastruttura per settimane prima di attivarsi, contaminando nel frattempo anche le copie. Ripristinare da un archivio già compromesso ripropone il problema invece di risolverlo. La contromisura è la scansione periodica degli archivi, condotta senza coinvolgere le postazioni, per individuare in anticipo il punto di ripristino pulito più recente.
Le sette verifiche da chiedere a chi gestisce backup e disaster recovery
- Esiste una copia fuori sede, su un supporto che non condivide alimentazione e rete con il sistema protetto.
- Esiste una copia immutabile, con finestra di inalterabilità configurata, che un attacco con credenziali amministrative non possa cifrare né cancellare.
- Qualcuno controlla ogni settimana l’esito dei processi e segnala le anomalie entro la giornata lavorativa successiva.
- Esiste un ripristino di prova documentato, con data, perimetro e durata effettiva, eseguito negli ultimi trenta giorni.
- Qualcuno ha provato sull’hardware reale il supporto di avvio per il ripristino da disco vuoto, così da escludere l’assenza dei driver di controller e scheda di rete.
- Esiste un documento operativo che elenca passo per passo chi fa che cosa nelle prime due ore, con nomi e recapiti aggiornati.
- Le responsabilità su backup e disaster recovery sono assegnate per iscritto, con un sostituto indicato per ogni ruolo.
Tre livelli di protezione e che cosa promettono
| Livello | Che cosa copre | Ordine di grandezza del ripristino |
|---|---|---|
| Copia giornaliera in sede | File eliminato o sovrascritto, errore applicativo circoscritto | Minuti sul singolo file, giorni se il server va sostituito |
| Copia fuori sede e archivio immutabile | Ransomware con credenziali amministrative, cancellazione intenzionale, incidente sul sito | Ore, secondo il volume e la connettività disponibile |
| Replica su secondo sito con avvio automatizzato | Guasto hardware bloccante, indisponibilità prolungata della sede primaria | Minuti, con procedura scritta e provata in anticipo |
Le domande che emergono quando si riapre il piano di continuità
Che cosa cambia tra un archivio immutabile e una copia offline su supporto rimovibile?
Il supporto rimovibile scollegato resta inattaccabile finché nessuno lo collega, ma introduce un passaggio manuale e un rischio di conservazione fisica. L’archivio immutabile ottiene lo stesso risultato senza intervento umano. Impostata la finestra, il dato non è cancellabile né modificabile fino alla scadenza, nemmeno con credenziali amministrative del cliente o del fornitore. Le finestre minime partono da quattordici giorni e si estendono secondo le esigenze di conservazione.
Conviene consolidare su un solo strumento di copia?
La frammentazione tra strumenti diversi per l’infrastruttura e per la posta in cloud produce due conseguenze misurabili. Responsabilità meno definite quando qualcosa non riesce, e una reportistica da ricomporre a mano prima di un audit. Il consolidamento è quasi sempre la direzione corretta, ma la scelta segue i requisiti da soddisfare e non l’abitudine. Un responsabile IT certificato ce lo ha posto nei termini giusti: la domanda non è quale prodotto preferire, è quale risponde ai requisiti dello standard applicato.
Che evidenze servono se un cliente o un revisore chiede conto della continuità?
Servono documenti, non dichiarazioni. Piano di continuità con revisione annuale, piano di ripristino con gli esiti dei test periodici, analisi di impatto aggiornata. Poi attestazione delle politiche di copia e delle attività di verifica, registro delle vulnerabilità, tracciamento degli interventi sui sistemi. È il pacchetto che le aziende in filiere regolamentate si sentono chiedere dai propri clienti, e che si costruisce nel tempo. Sulla gestione continuativa e sulla produzione delle evidenze abbiamo raccolto il modello operativo nell’articolo dedicato all’IT gestito a canone rispetto al break-fix.
Con che frequenza conviene eseguire un ripristino di prova?
Nei piani avanzati che gestiamo si eseguono e si documentano test mensili su campioni rappresentativi, con l’esito riportato nella rendicontazione periodica. Per gli ambienti virtualizzati si affianca il test di avviabilità, che verifica la partenza effettiva della macchina e non solo la leggibilità dell’archivio. La frequenza segue comunque il valore del sistema: ciò che sostiene l’operatività quotidiana richiede una verifica più ravvicinata rispetto agli archivi storici.
Un obbligo normativo impone un secondo sito?
Dipende dal settore e dal ruolo dell’azienda nella filiera, e la verifica spetta a un consulente normativo. Sul piano dei principi vale l’articolo 32 del Regolamento generale sulla protezione dei dati. Richiede la capacità di ripristinare tempestivamente disponibilità e accesso ai dati dopo un incidente fisico o tecnico. Richiede anche una procedura per verificare periodicamente l’efficacia delle misure adottate. La verifica periodica, quindi, non è una buona pratica facoltativa.
Parliamone
Il modo più rapido per capire a che punto è un’azienda su backup e disaster recovery è fissare una data e provare. Non un’esercitazione teorica: un ripristino reale su un sistema scelto insieme, con il cronometro acceso e il risultato messo per iscritto. È la prima cosa che mettiamo in calendario nella consulenza gratuita, prima di qualunque proposta. Quel numero è l’unico che conta il giorno del fermo. Nella maggior parte dei casi è diverso da quello che la direzione ha in mente.
Aesir Srl opera come MSP e MSSP nello stesso perimetro contrattuale, con datacenter Tier IV proprietari in Unione Europea e replica. Le certificazioni sono ISO 9001, 27001, 27017 e 27018, con allineamento volontario a NIS2, e i progetti coprono tutta Italia. Se desidera approfondire il tema o valutare la situazione della sua azienda, può compilare la form in fondo alla pagina oppure scrivere a support@aesir-tech.it: prenotiamo una consulenza gratuita e partiamo dai suoi numeri.